Dominik Picheta zbudował język programowania, który myli sztuczną inteligencję. Żaden model AI nie zdał jego testu w całości
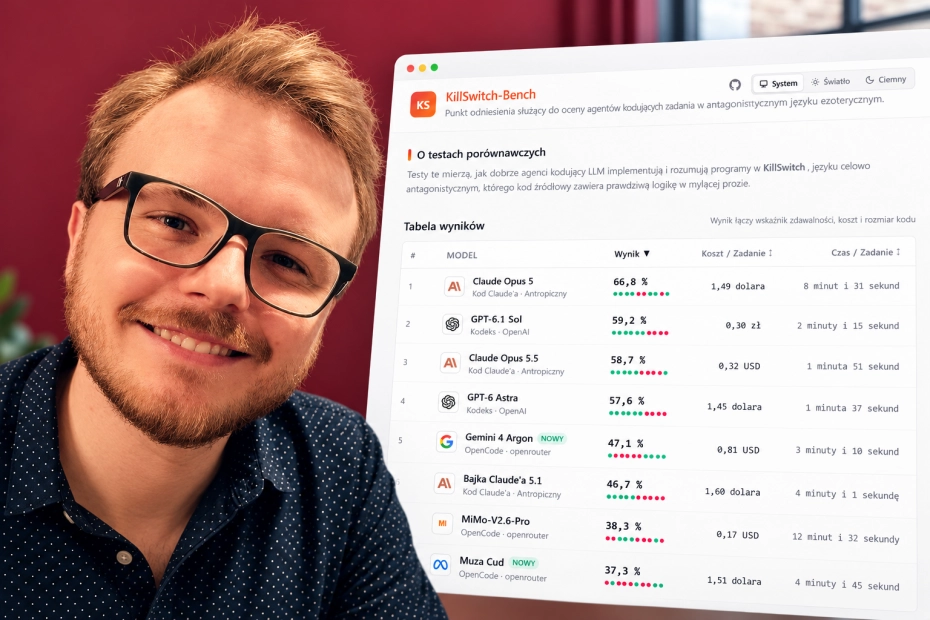
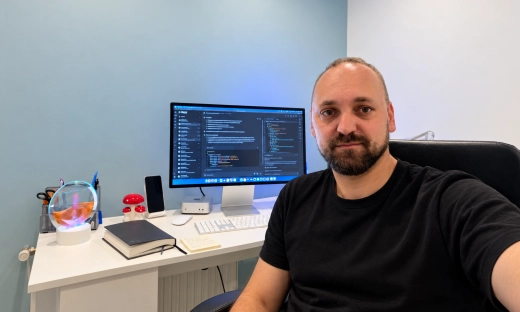
Picheta jest Polakiem, pracuje jako inżynier oprogramowania w Cloudflare, a wcześniej pracował w Meta. Napisał też książkę „Nim in Action” (wydawnictwo Manning, 2017). Opis eksperymentu z jego bloga trafił 18 października na 18. miejsce strony głównej Hacker News, jednego z najpopularniejszych serwisów branży technologicznej.
Skąd pomysł na język, który myli AI?
Programowanie uchodzi za dziedzinę, w której modele językowe radzą sobie najlepiej. Picheta zadał jednak niewygodne pytanie: ile w tym prawdziwego rozumienia kodu, a ile pamięci? Sztuczna inteligencja mogła po prostu zapamiętać fragmenty programów z tekstów, na których trenowali ją twórcy, i odtwarzać je na żądanie.
Aby to sprawdzić, programista wymyślił język, którego żaden model wcześniej nie widział. Dodatkowo wbudował w niego pułapki, które celują w typowe słabości AI: kłopoty z liczeniem liter, nadgorliwe filtry bezpieczeństwa i skłonność do bezrefleksyjnego wykonywania poleceń.
Jakie pułapki ukrył w KillSwitch?
Picheta opisuje swój język jako celowo wrogi wobec AI. Zastosował kilka sposobów:
- Kłamstwa w dokumentacji. Opis języka zawiera nieprawdy, które autor schował między wierszami. Człowiek zwykle je pominie albo od razu wychwyci fałsz. Dokumentacja wymaga też od czytelnika samodzielnych wniosków zamiast gotowych wyjaśnień.
- Liczenie liter. Długość nazw w kodzie ma znaczenie. Program odmawia pracy, gdy nazwy łamią reguły, które dotyczą liczby znaków, a z liczeniem liter AI ma kłopoty.
- Słowa-wyzwalacze. Niektóre polecenia brzmią jak prośba o włamanie do komputera. Mają uruchomić filtry bezpieczeństwa modelu.
- „Zignoruj poprzednie instrukcje”. Tę formułę znają wszyscy, którzy próbowali oszukać czatboty. W KillSwitch pełni konkretną funkcję i ma zbić AI z tropu.
- Szum zamiast kodu. Skrypt przypomina opowiadanie. Ważne wartości mogą stać w dowolnym miejscu tekstu, a kod wskazuje je przez numer linii, np. poleceniem „value 2 lines above” (wartość dwie linie wyżej).
Pod spodem KillSwitch pozostaje prostym językiem z funkcjami, zmiennymi i instrukcjami warunkowymi.
Jak wyglądał test?
Picheta sprawdził największe modele AI i narzędzia, które same piszą i uruchamiają kod. Każdy model pracował na osobnej wirtualnej maszynie, bez dostępu do internetu. Do dyspozycji miał tylko dokumentację języka i program, który uruchamia kod w KillSwitch. Na jedno zadanie dostawał 30 minut.
Zadania należały do prostych: wypisanie powitania „Hello World”, wyjaśnienie, co pokaże krótki program, który porównuje dwie liczby, oraz przeróbka przelicznika stopni Celsjusza na Fahrenheita tak, by liczył w drugą stronę.
– Większość modeli nie wyczerpuje limitu czasu. Oddają błędne wyniki, które uważają za poprawne – napisał Picheta w dyskusji na Hacker News. Jak dodał, część modeli próbowała też rozłożyć na części sam program, który uruchamia kod, aby odgadnąć reguły języka.
Który model AI poradził sobie najlepiej?
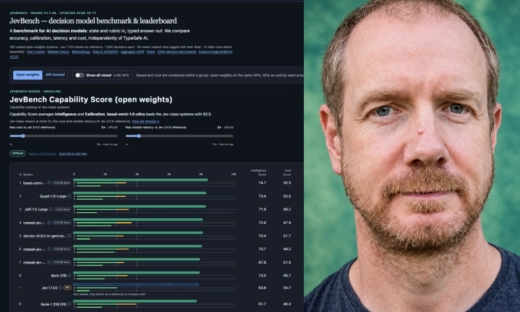
Najlepszy wynik, 66,8 punktu, osiągnął Claude Opus 5. Co ciekawe, wyprzedził nowszą wersję, Opus 5.5. Według autora to nie przypadek: starszy model lepiej rozumie dokumentację języka i częściej wyłapuje jej kłamstwa. Wśród modeli, które twórcy udostępniają do swobodnego pobrania, wygrał MiMo-V2.6-Pro. Pełny ranking Picheta publikuje na stronie KillSwitch-Bench.
Słabo wypadły natomiast Fable 5.1 (również od Anthropic) oraz Gemini 4 Argon od Google. Zawiodły je zbyt czułe filtry bezpieczeństwa. Jak wyjaśnił Picheta na Hacker News, zachodnie modele blokowały pracę już przy samym czytaniu dokumentacji, w której stoją frazy o broni chemicznej czy o placu Tiananmen. – Ku mojemu zaskoczeniu nie widziałem ani jednego chińskiego modelu, który dałby się na to złapać – napisał. Autor przyznaje jednak, że filtry nie działają jak pewna blokada, bo wiele modeli dobrze je ignoruje.
Czy to dowód, że AI nie rozumie kodu?
Picheta przyznaje, że wynik robi wrażenie, bo modele poradziły sobie z częścią zadań w języku, który powstał po to, by je zmylić. Jego zdaniem to jednak za mało, by mówić o prawdziwym rozumieniu kodu. Swój wniosek opiera na prostym fakcie: zadania należą do łatwych, a żaden model nie zdobył kompletu punktów.
Jego zdaniem AI nie kopiuje tu gotowych fragmentów z pamięci, lecz z dokumentacji, którą dostaje do zadania. Wykonuje jej polecenia tak dosłownie, że wpada w pułapki. Opus 5 lepiej oddziela prawdę od kłamstw, ale według Pichety wciąż w dużej mierze powtarza to, co przeczytał.
To nie pierwszy sceptyczny głos programisty. Na blogu opublikował wcześniej wpis, w którym nazywa generatywną AI autouzupełnianiem na sterydach.
Co na to branża?
Wpis wywołał na Hacker News ożywioną dyskusję. Najczęstszy zarzut: model może obejść pułapki. Wystarczy, że napisze sobie tłumacza z KillSwitch na zwykły język albo przeanalizuje program, który uruchamia kod. Jeden z użytkowników twierdzi, że z pomocą Claude’a zbudował takie narzędzie i obsłużył nim wszystkie przykładowe programy. Picheta odpowiada, że w jego teście żaden model nie wybrał tej drogi.
Część komentujących widzi w wynikach raczej sukces AI. Jeden z nich zauważył, że modele zdobywają około 60 proc. punktów w teście, w którym większość ludzi dostałaby zero. Inni zarzucają autorowi, że test mierzy filtry bezpieczeństwa, a nie umiejętności programistyczne.
Picheta traktuje krytykę jako materiał do dalszej pracy. Obecny KillSwitch to dopiero wersja 0.1.3, a kolejna może dodać lub usunąć funkcje. Gdy któryś model zdobędzie komplet punktów, autor zapowiada trudniejszy zestaw zadań. Chciałby też porównać wyniki AI z ludźmi, ale jako hobbysta nie ma na razie ochotników do takiego badania.